PPKIAPPKIA
Journal of Big Data Analytic and Artificial IntelligenceJournal of Big Data Analytic and Artificial IntelligencePenggunaan metrik-metrik validasi internal secara bersamaan untuk menentukan jumlah klaster optimal pada algoritma K-Means Clustering berpotensi memberikan nilai K yang berbeda-beda dan membingungkan bagi pengguna data untuk mengekstraksi informasi seperti untuk identifikasi karakteristik pelanggan. Penelitian ini bertujuan mengembangkan framework evaluasi untuk mengatasi ambiguitas nilai K dari beberapa metrik validasi internal. Framework evaluasi nilai K terdiri dari 2 tahap, dengan tahap pertama menggunakan lima metrik validasi, DBI, Silhouette Score, Elbow Method, Dunn Index dan Calinski-Harabasz Index sebagai filter untuk menghasilkan maksimal 5 nilai K terbaik. Evaluasi tahap kedua menggunakan analisis boxplot, inter quartile range dan elbow untuk mengeksplorasi tingkat kohesifitas dan stabilitas klaster yang terbentuk. Hasil yang diperoleh dari evaluasi tahap 1 terdapat 4 opsi jumlah klaster, K=2, 5, 7 dan 10. Evaluasi tahap kedua menunjukkan dari grafik elbow nilai rata-rata inter quartile range, K=5 menjadi jumlah klaster yang optimal dibanding 3 nilai K lainnya. Hasil ini menunjukkan bahwa semakin banyak metrik validasi internal yang digunakan, berpotensi menghasilkan banyak nilai K. Semakin banyak jumlah klaster tidak menjamin semakin baik kualitasnya. Implikasi dari penelitian ini menunjukkan pentingnya pendekatan evaluasi berlapis dalam menentukan jumlah klaster optimal, terutama saat menggunakan banyak metrik validasi internal secara bersamaan. Framework yang dikembangkan dapat membantu praktisi data dalam membuat keputusan yang lebih terinformasi dan mengurangi ambiguitas dalam proses klasterisasi. Ke depan, framework ini dapat dikembangkan lebih lanjut dengan mengintegrasikan metrik eksternal atau diadaptasi untuk algoritma klasterisasi lainnya.
Penelitian ini berhasil mengembangkan framework evaluasi dua tahap untuk menentukan jumlah klaster optimal pada K-Means Clustering.Hasil menunjukkan bahwa K=5 merupakan jumlah klaster terbaik berdasarkan analisis boxplot dan inter quartile range.Penelitian ini menegaskan bahwa penggunaan metrik validasi internal yang lebih banyak tidak selalu meningkatkan kualitas klaster, sehingga diperlukan pendekatan evaluasi berlapis untuk memastikan stabilitas dan kohesivitas klaster.Framework yang diusulkan dapat menjadi panduan bagi praktisi data dalam mengurangi ambiguitas hasil klasterisasi.
1. Penelitian lanjutan dapat mengintegrasikan metrik validasi eksternal untuk membandingkan hasil klasterisasi dengan data referensi. 2. Pengembangan framework ini untuk algoritma klasterisasi lain seperti DBSCAN atau Hierarchical Clustering agar lebih fleksibel. 3. Studi eksperimental untuk mengevaluasi dampak perubahan dataset terhadap optimalisasi jumlah klaster, terutama pada data yang lebih kompleks atau berukuran besar.
- Comparison of K-Means and K-Medoids Algorithms for Grouping Cocoa Production Areas | Jurnal Teknik Informatika... doi.org/10.28932/jutisi.v8i2.4897Comparison of K Means and K Medoids Algorithms for Grouping Cocoa Production Areas Jurnal Teknik Informatika doi 10 28932 jutisi v8i2 4897
- Comparison of Agglomerative Hierarchical and K-Means in Grouping Provinces Based on Maternal Health Services... sistemasi.ftik.unisi.ac.id/index.php/stmsi/article/view/1829Comparison of Agglomerative Hierarchical and K Means in Grouping Provinces Based on Maternal Health Services sistemasi ftik unisi ac index php stmsi article view 1829
- Metode Elbow dalam Optimasi Jumlah Cluster pada K-Means Clustering | Simetris: Jurnal Teknik Mesin, Industri,... doi.org/10.24176/simet.v14i2.9630Metode Elbow dalam Optimasi Jumlah Cluster pada K Means Clustering Simetris Jurnal Teknik Mesin Industri doi 10 24176 simet v14i2 9630
| File size | 511.77 KB |
| Pages | 6 |
| DMCA | Report |
Related /

PELITABANGSAPELITABANGSA Penelitian ini menyimpulkan bahwa metode clustering K-Means efektif digunakan untuk mengelompokkan data penjualan dan mendukung proses pengambilan keputusanPenelitian ini menyimpulkan bahwa metode clustering K-Means efektif digunakan untuk mengelompokkan data penjualan dan mendukung proses pengambilan keputusan

FKPTFKPT Alur penelitian dimulai dari identifikasi masalah, studi literatur, pengumpulan dan pre-processing data, hingga implementasi algoritma untuk menghasilkanAlur penelitian dimulai dari identifikasi masalah, studi literatur, pengumpulan dan pre-processing data, hingga implementasi algoritma untuk menghasilkan

FOURIERFOURIER Dalam penanganan masalah inflasi di berbagai wilayah, variabel dan keadaan unik di setiap daerah sangatlah penting untuk dipertimbangkan. Penelitian iniDalam penanganan masalah inflasi di berbagai wilayah, variabel dan keadaan unik di setiap daerah sangatlah penting untuk dipertimbangkan. Penelitian ini

UBMUBM Masalah utama yang dibahas adalah pemilihan mode dan fitur warna yang optimal untuk mencapai efek kartun. Dalam metodologi, digunakan mode warna HSI (Hue,Masalah utama yang dibahas adalah pemilihan mode dan fitur warna yang optimal untuk mencapai efek kartun. Dalam metodologi, digunakan mode warna HSI (Hue,
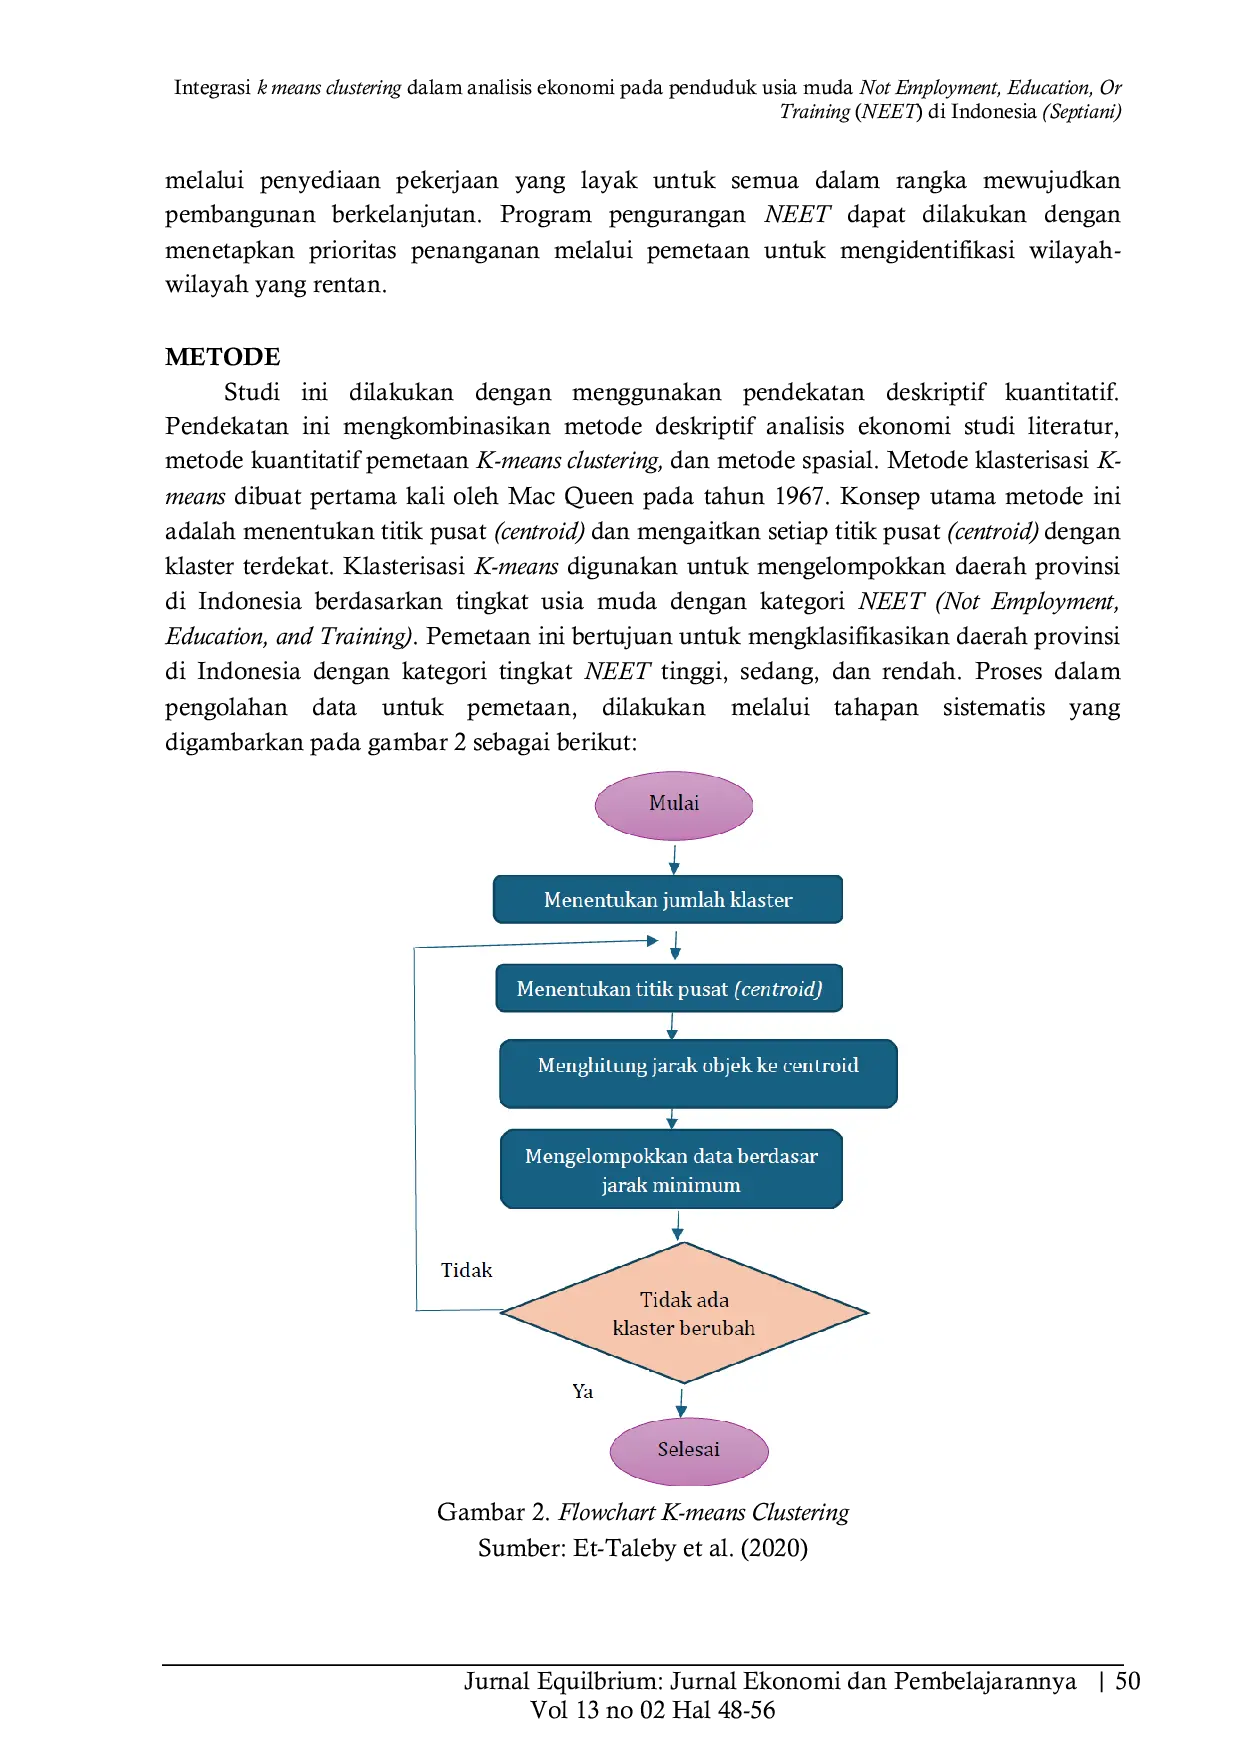
UNIPMAUNIPMA Berdasarkan hasil pemetaan, wilayah penelitian terbagi menjadi 3 klaster. Daerah klaster 1 merupakan daerah dengan persentase usia muda kategori NEET tertinggiBerdasarkan hasil pemetaan, wilayah penelitian terbagi menjadi 3 klaster. Daerah klaster 1 merupakan daerah dengan persentase usia muda kategori NEET tertinggi
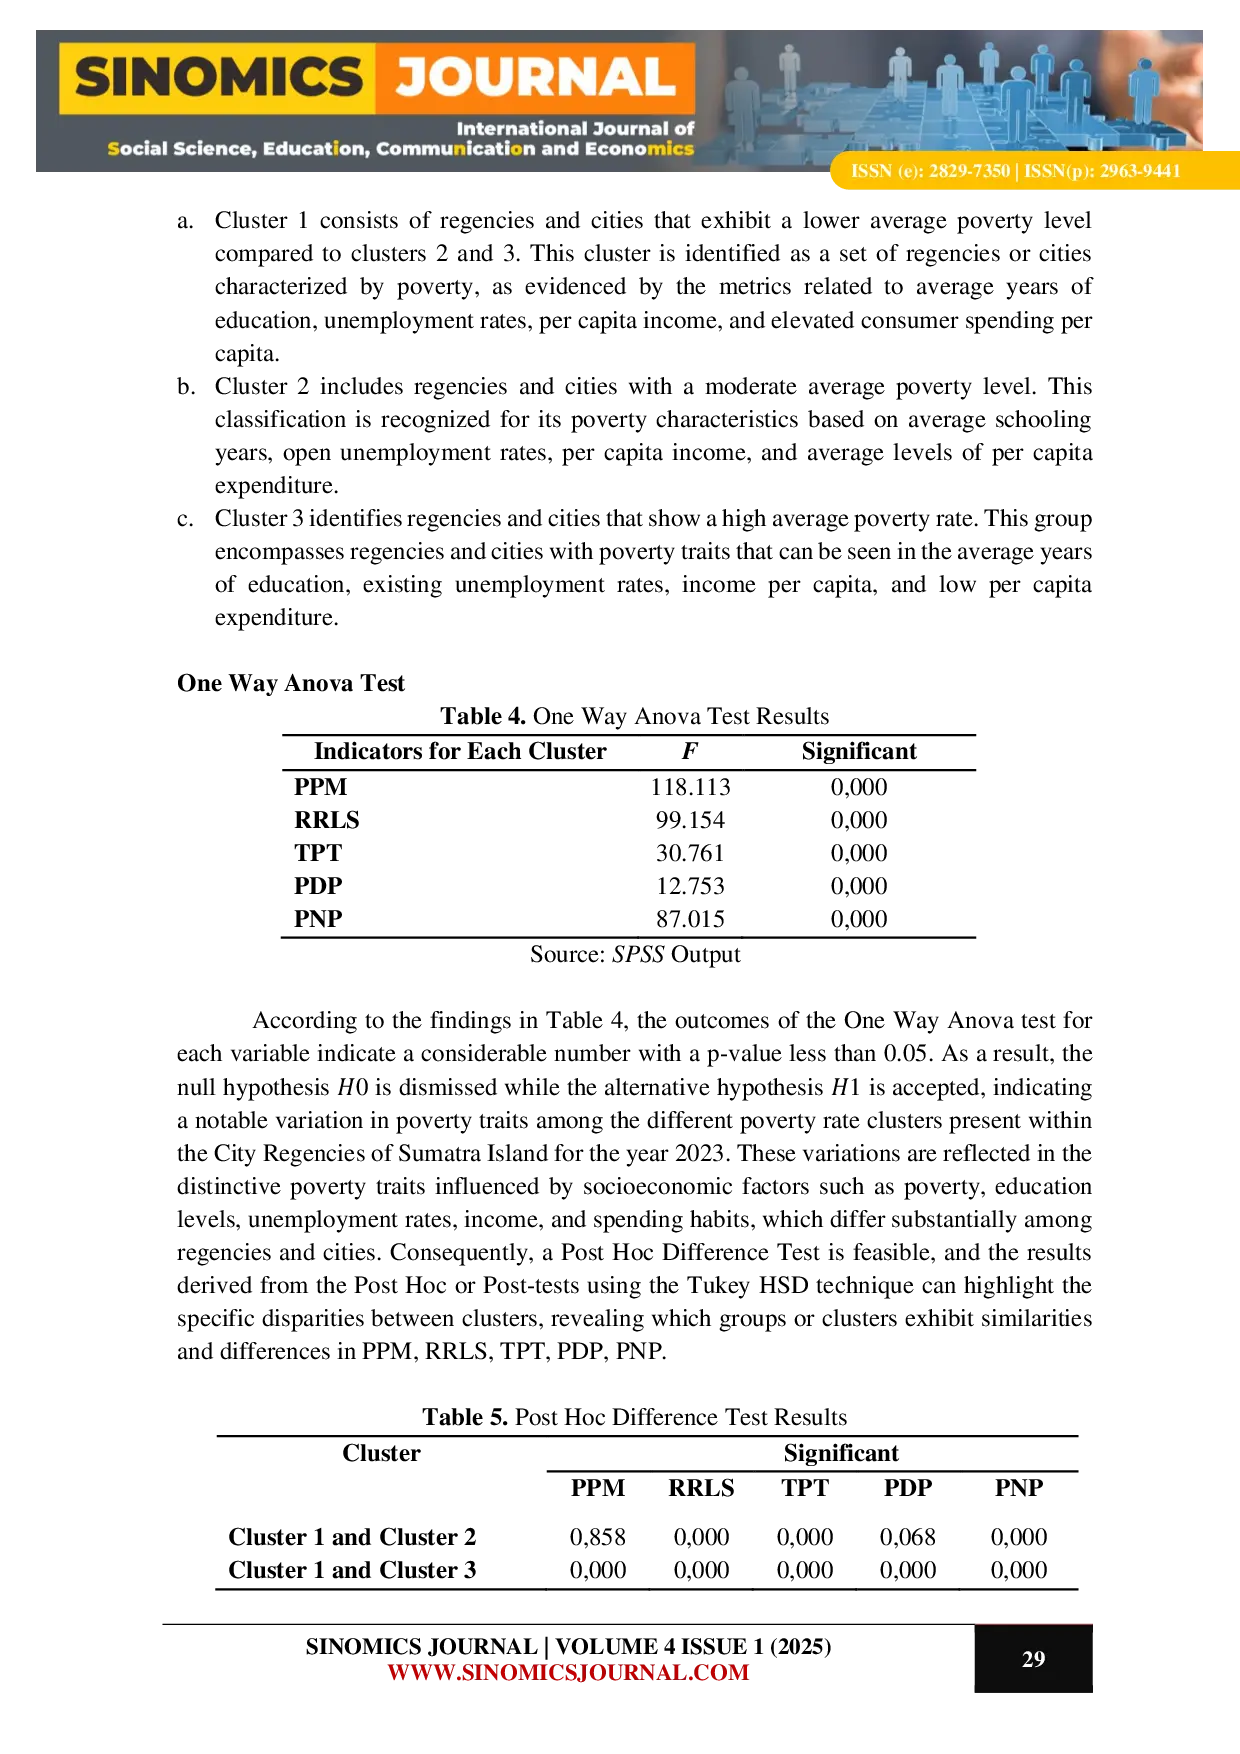
SINOMICSJOURNALSINOMICSJOURNAL Penelitian ini bertujuan untuk mengkaji kemiskinan di kabupaten dan kota di Pulau Sumatera pada tahun 2023 dengan menggunakan pendekatan K-Means Clustering.Penelitian ini bertujuan untuk mengkaji kemiskinan di kabupaten dan kota di Pulau Sumatera pada tahun 2023 dengan menggunakan pendekatan K-Means Clustering.

STMIK BANJARBARUSTMIK BANJARBARU Dari penggunaan metode ini, didapatkan hasil bahwa penggunaan K-means Clustering dengan jumlah 3 klaster lebih optimal dibandingkan jumlah klaster yangDari penggunaan metode ini, didapatkan hasil bahwa penggunaan K-means Clustering dengan jumlah 3 klaster lebih optimal dibandingkan jumlah klaster yang

UNSURUNSUR Permasalahan ini terlihat dari jumlah penginap selama 1 bulan yang fluktuatif. Sehingga jumlah pengujung hotel sedikit. Tujuan penelitian ini untuk mengetahuiPermasalahan ini terlihat dari jumlah penginap selama 1 bulan yang fluktuatif. Sehingga jumlah pengujung hotel sedikit. Tujuan penelitian ini untuk mengetahui
Useful /

STIKES HOLISTICSTIKES HOLISTIC Prevalensi gizi remaja di Jawa Barat pada tahun 2018 terdapat 9,2% dengan kategori kurus, 54,1% dengan kategori normal, 13,7% dengan kategori berat badanPrevalensi gizi remaja di Jawa Barat pada tahun 2018 terdapat 9,2% dengan kategori kurus, 54,1% dengan kategori normal, 13,7% dengan kategori berat badan
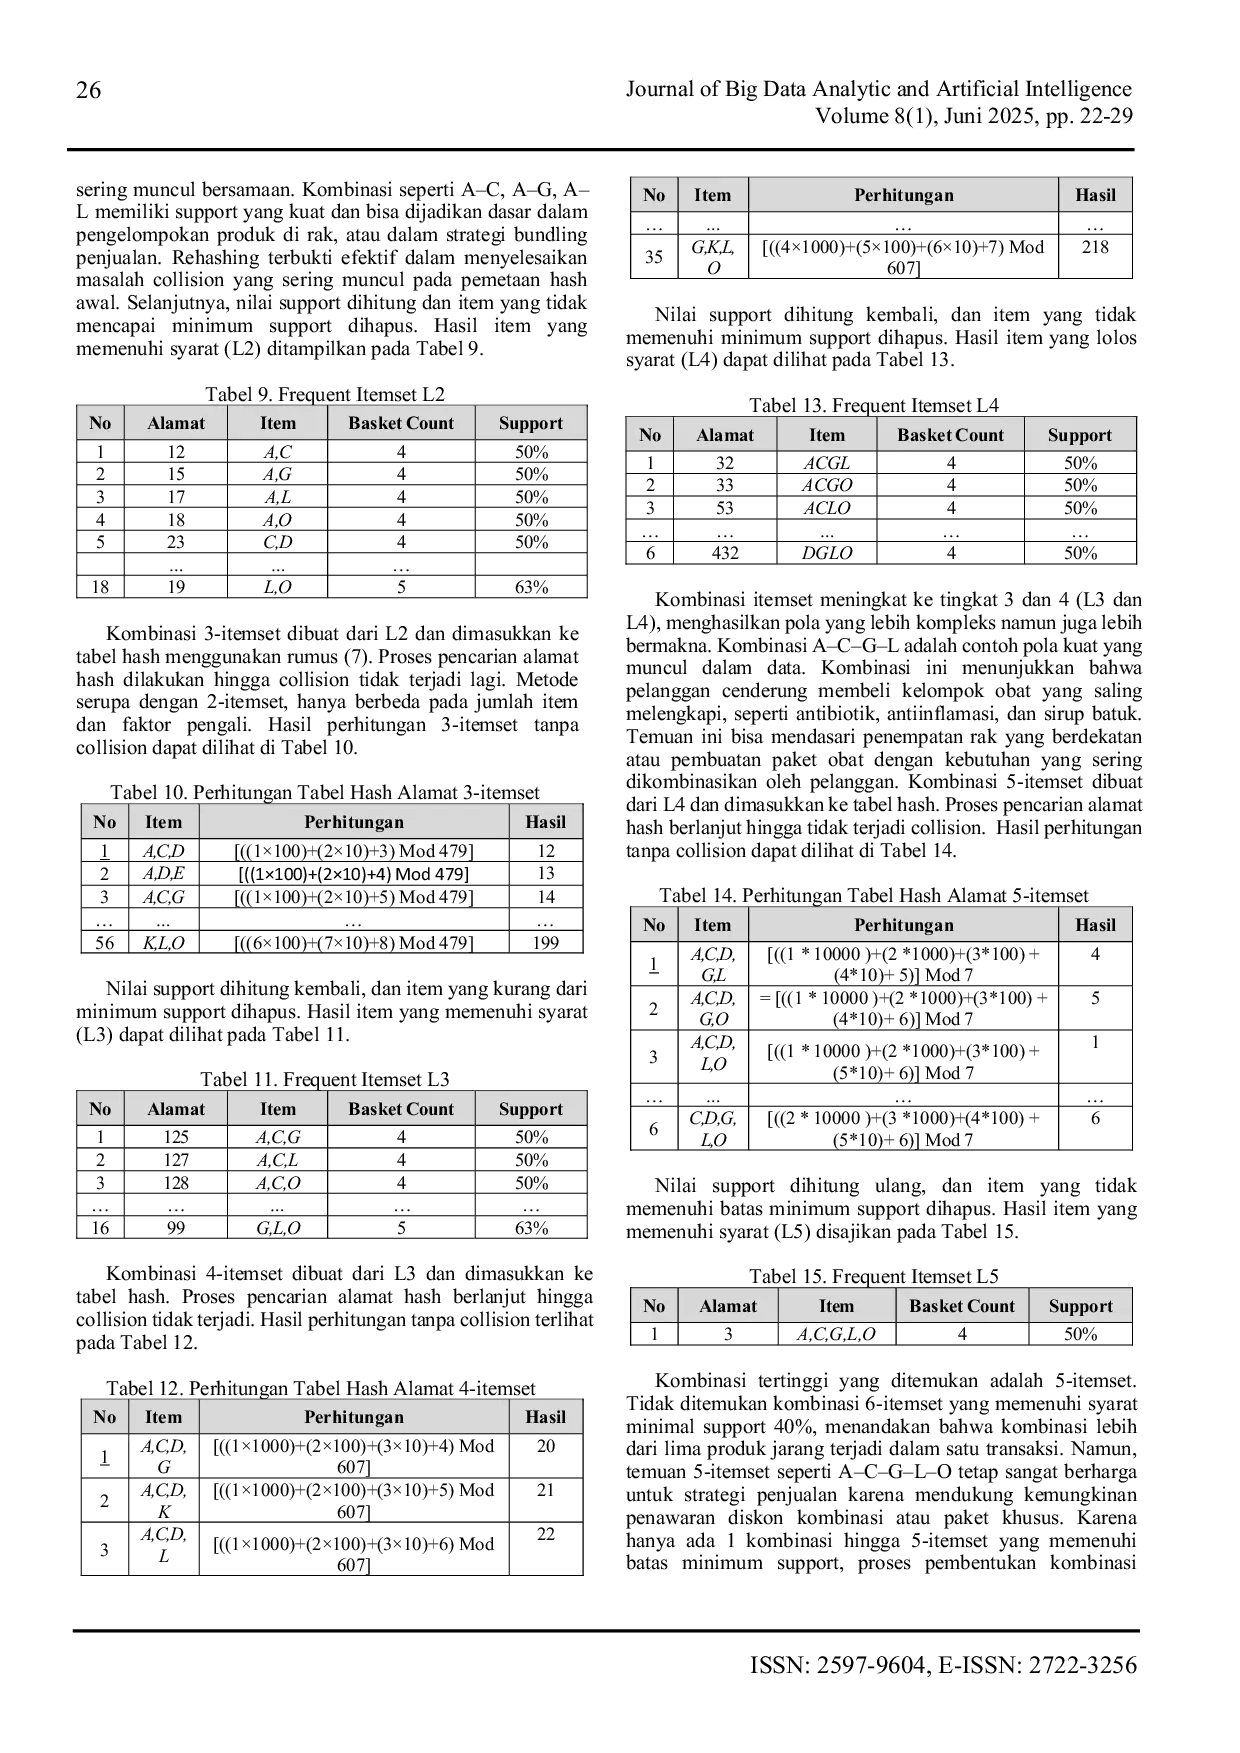
PPKIAPPKIA Temuan ini menunjukkan adanya pola pembelian yang konsisten, terutama pada obat-obatan seperti Amoxicillin, Asam Mefenamat, Dexteem Plus, dan Voltadex.Temuan ini menunjukkan adanya pola pembelian yang konsisten, terutama pada obat-obatan seperti Amoxicillin, Asam Mefenamat, Dexteem Plus, dan Voltadex.
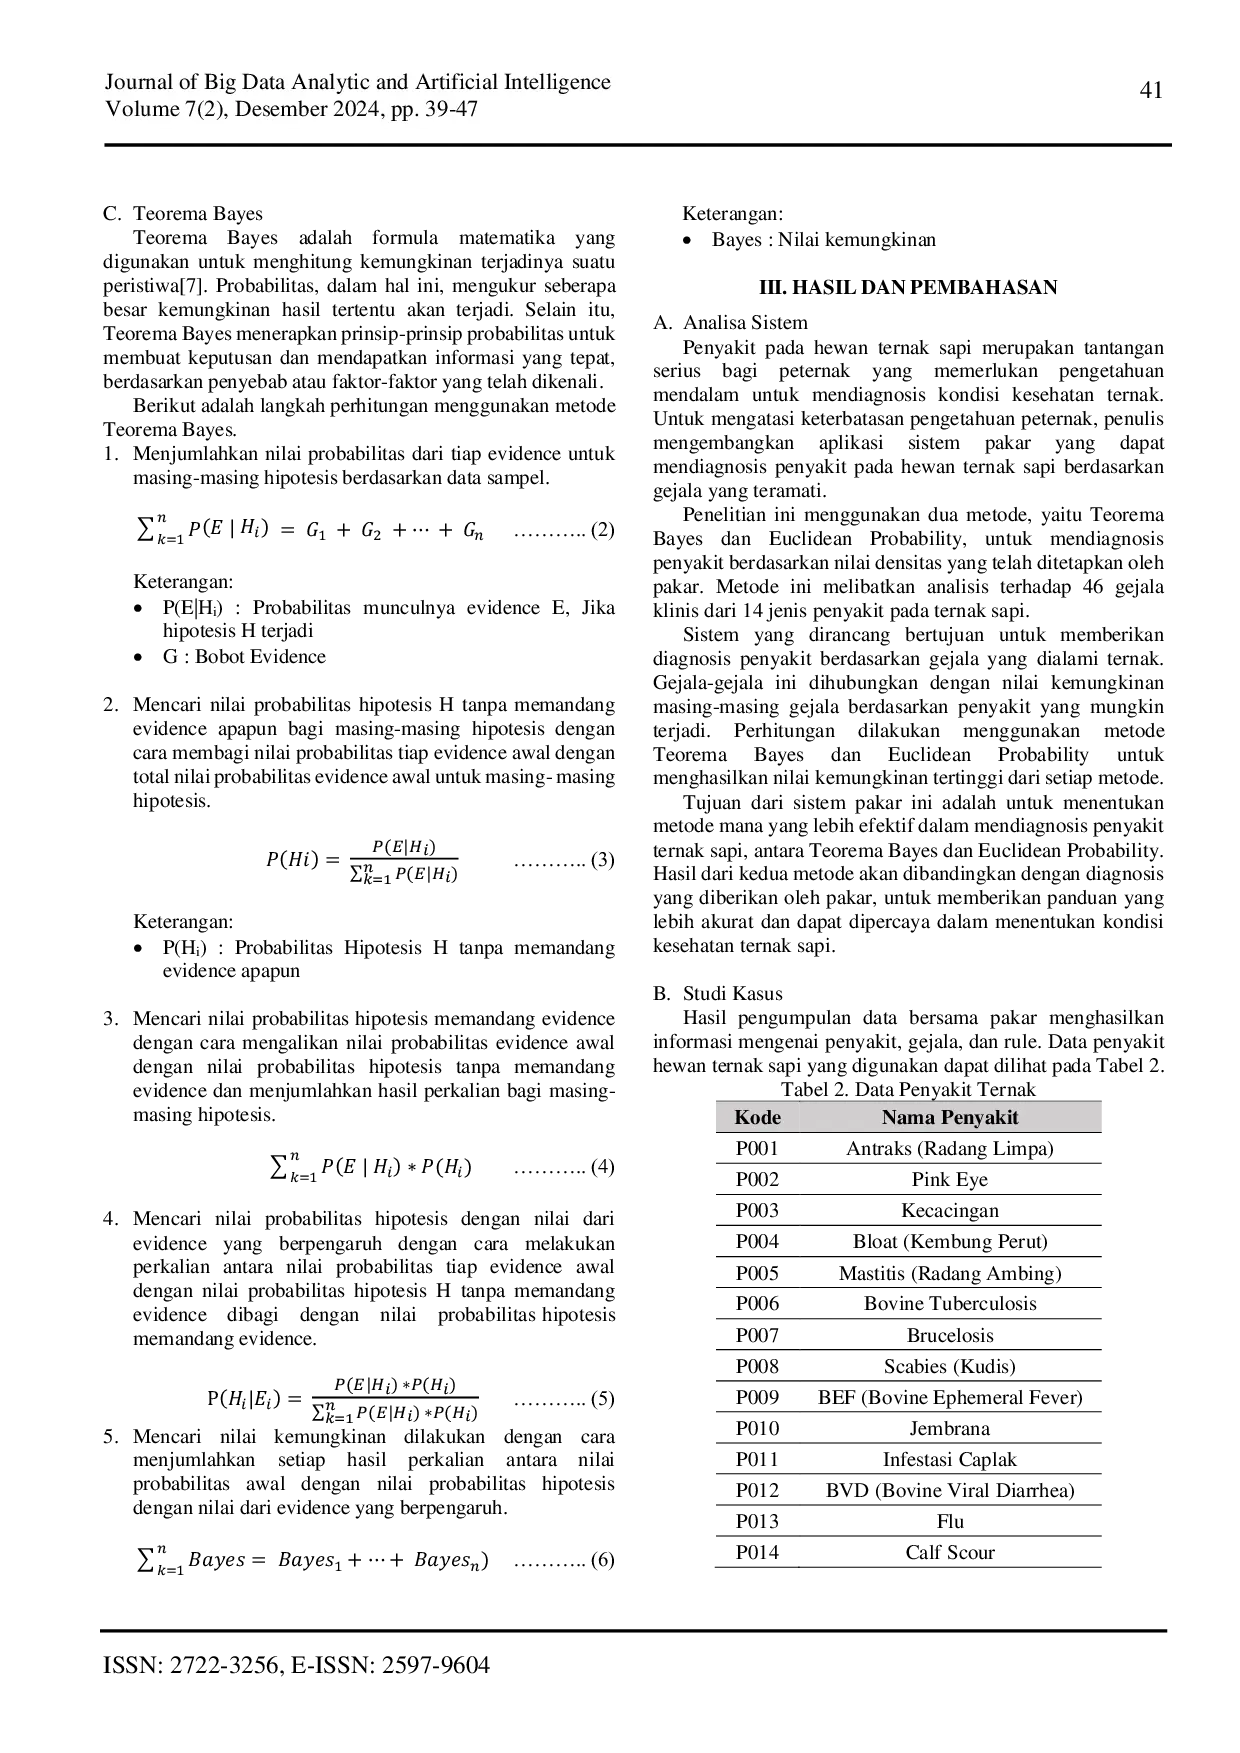
PPKIAPPKIA Hal ini menyimpulkan bahwa metode Euclidean Probability lebih efektif daripada metode teorema bayes dalam mendiagnosa penyakit ternak sapi. PenelitianHal ini menyimpulkan bahwa metode Euclidean Probability lebih efektif daripada metode teorema bayes dalam mendiagnosa penyakit ternak sapi. Penelitian
PPKIAPPKIA Penelitian ini berhasil mengembangkan aplikasi klasifikasi kelayakan penerima bantuan sosial menggunakan metode K-Nearest Neighbor yang menunjukkan akurasiPenelitian ini berhasil mengembangkan aplikasi klasifikasi kelayakan penerima bantuan sosial menggunakan metode K-Nearest Neighbor yang menunjukkan akurasi