UBUB
Journal of Information Technology and Computer ScienceJournal of Information Technology and Computer ScienceSekolah Menengah Kejuruan (SMK) bertujuan menghasilkan lulusan yang siap kerja. Namun, tingkat pengangguran terbuka (TPT) lulusan SMK masih tinggi mencapai 9,01%, menunjukkan adanya kesenjangan kompetensi. Penelitian ini merancang model prediksi kesiapan kerja lulusan menggunakan algoritma Naive Bayes yang dikombinasikan dengan Teknik Oversampling Minoritas Sintetis (SMOTE). SMOTE digunakan untuk mengatasi ketidakseimbangan kelas antara lulusan kompeten dan tidak kompeten. Penelitian ini mengikuti metodologi Cross-Industry Standard Process for Data Mining (CRISP-DM), memanfaatkan data nilai akademik dan studi tracer. Hasil evaluasi menunjukkan bahwa penerapan SMOTE dengan pembagian data 70:30 berhasil meningkatkan akurasi model menjadi 97%. Model juga efektif mendeteksi kelas minoritas dengan Recall sebesar 90%. Selain itu, validasi silang menghasilkan rata-rata akurasi 97,66%, menunjukkan kinerja stabil. Akhirnya, model diimplementasikan sebagai dashboard berbasis web untuk menjadi sistem peringatan dini bagi sekolah.
Penelitian ini mengembangkan model prediksi kesiapan kerja lulusan SMK menggunakan algoritma Gaussian Naive Bayes yang dikombinasikan dengan teknik SMOTE untuk mengatasi ketidakseimbangan kelas.Hasil eksperimen menunjukkan bahwa model GNB SMOTE mencapai akurasi 97% dengan presisi, recall, dan F1-score yang baik pada kedua kelas mayoritas dan minoritas.Validasi silang menghasilkan rata-rata akurasi 97,66% dengan variasi kinerja rendah, menunjukkan kestabilan dan konsistensi model.Evaluasi benchmark menunjukkan bahwa GNB lebih unggul dibanding Decision Tree dalam konfigurasi SMOTE yang sama, sehingga lebih cocok untuk dataset pendidikan saat ini.Model dikembangkan menjadi dashboard berbasis Streamlit untuk memantau dan memvisualisasikan prediksi kompetensi lulusan.Meski hasil menjanjikan, penelitian ini masih terbatas pada dataset kecil dari satu program vokasional.Penelitian masa depan disarankan untuk memperluas cakupan dataset, memasukkan variabel non-akademik, dan mengeksplorasi teknik balancing atau algoritma klasifikasi lain untuk meningkatkan performa prediksi dan generalisasi model.
Penelitian lanjutan dapat fokus pada evaluasi model dengan dataset lebih besar dari berbagai program vokasional untuk meningkatkan generalisasi. Kedua, integrasi variabel non-akademik seperti soft skills atau pengalaman kerja dalam prediksi kesiapan kerja. Ketiga, eksplorasi teknik balancing lain seperti ADASYN atau SMOTE-ENN untuk membandingkan performa dengan SMOTE yang digunakan dalam penelitian ini.
- The Impact of Balanced Data Techniques on Classification Model Performance | Scientific Journal of Informatics.... journal.unnes.ac.id/journals/sji/article/view/3649The Impact of Balanced Data Techniques on Classification Model Performance Scientific Journal of Informatics journal unnes ac journals sji article view 3649
- View of Confusion Matrix-Based Performance Evaluation Metrics. view confusion matrix based performance... africanjournalofbiomedicalresearch.com/index.php/AJBR/article/view/4345/3327View of Confusion Matrix Based Performance Evaluation Metrics view confusion matrix based performance africanjournalofbiomedicalresearch index php AJBR article view 4345 3327
- Analisis Performa Algoritma NBC, DT, SVM dalam Klasifikasi Data Ulasan Pengunjung Candi Borobudur Berbasis... doi.org/10.47065/bits.v4i3.2766Analisis Performa Algoritma NBC DT SVM dalam Klasifikasi Data Ulasan Pengunjung Candi Borobudur Berbasis doi 10 47065 bits v4i3 2766
- Implementasi Algoritma Naïve Bayes Menggunakan Feature Forward Selection dan SMOTE Untuk Memprediksi... doi.org/10.37396/jsc.v5i2.215Implementasi Algoritma Nayve Bayes Menggunakan Feature Forward Selection dan SMOTE Untuk Memprediksi doi 10 37396 jsc v5i2 215
| File size | 499.13 KB |
| Pages | 12 |
| DMCA | Report |
Related /
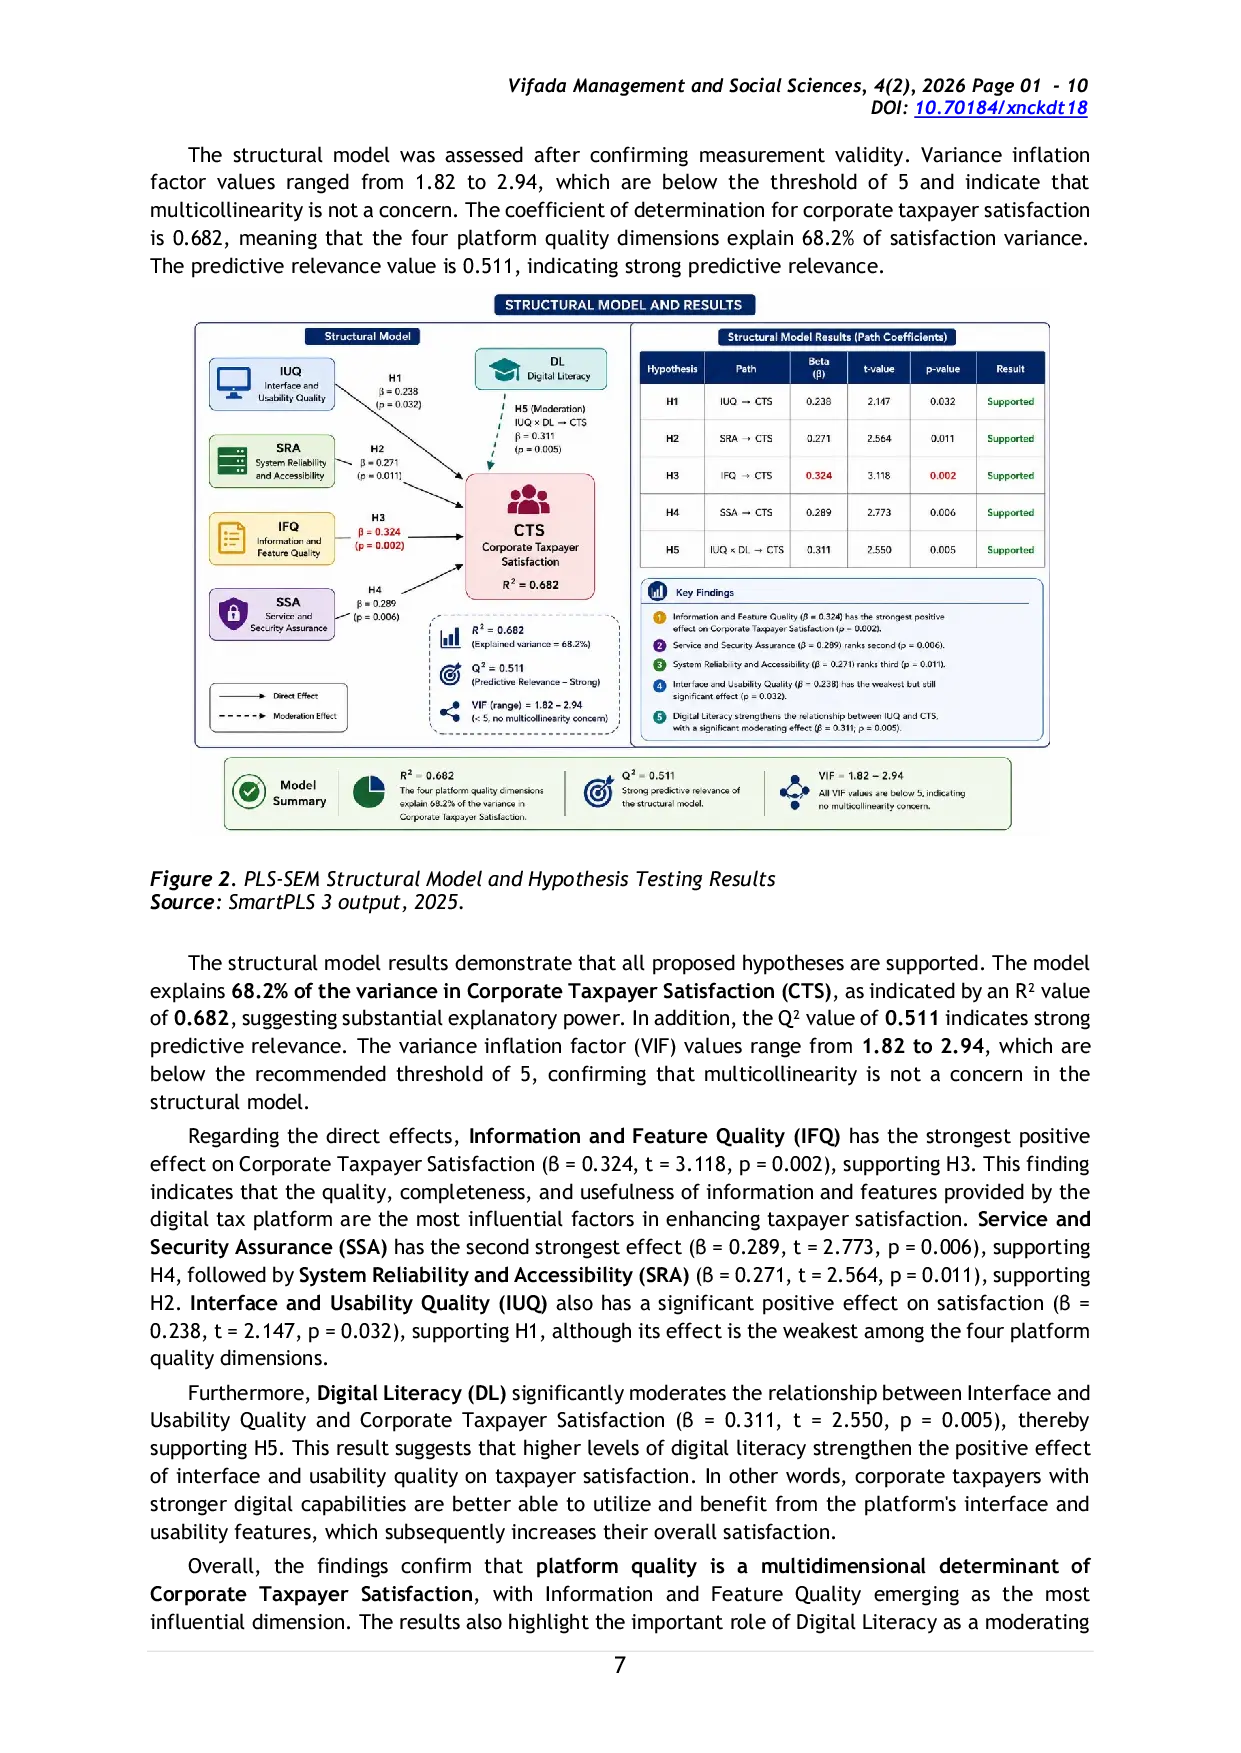
VIFADAVIFADA Implikasi: Otoritas pajak harus memprioritaskan integrasi fitur, stabilitas sistem, jaminan layanan dan keamanan, kegunaan antarmuka, serta kemampuan digitalImplikasi: Otoritas pajak harus memprioritaskan integrasi fitur, stabilitas sistem, jaminan layanan dan keamanan, kegunaan antarmuka, serta kemampuan digital
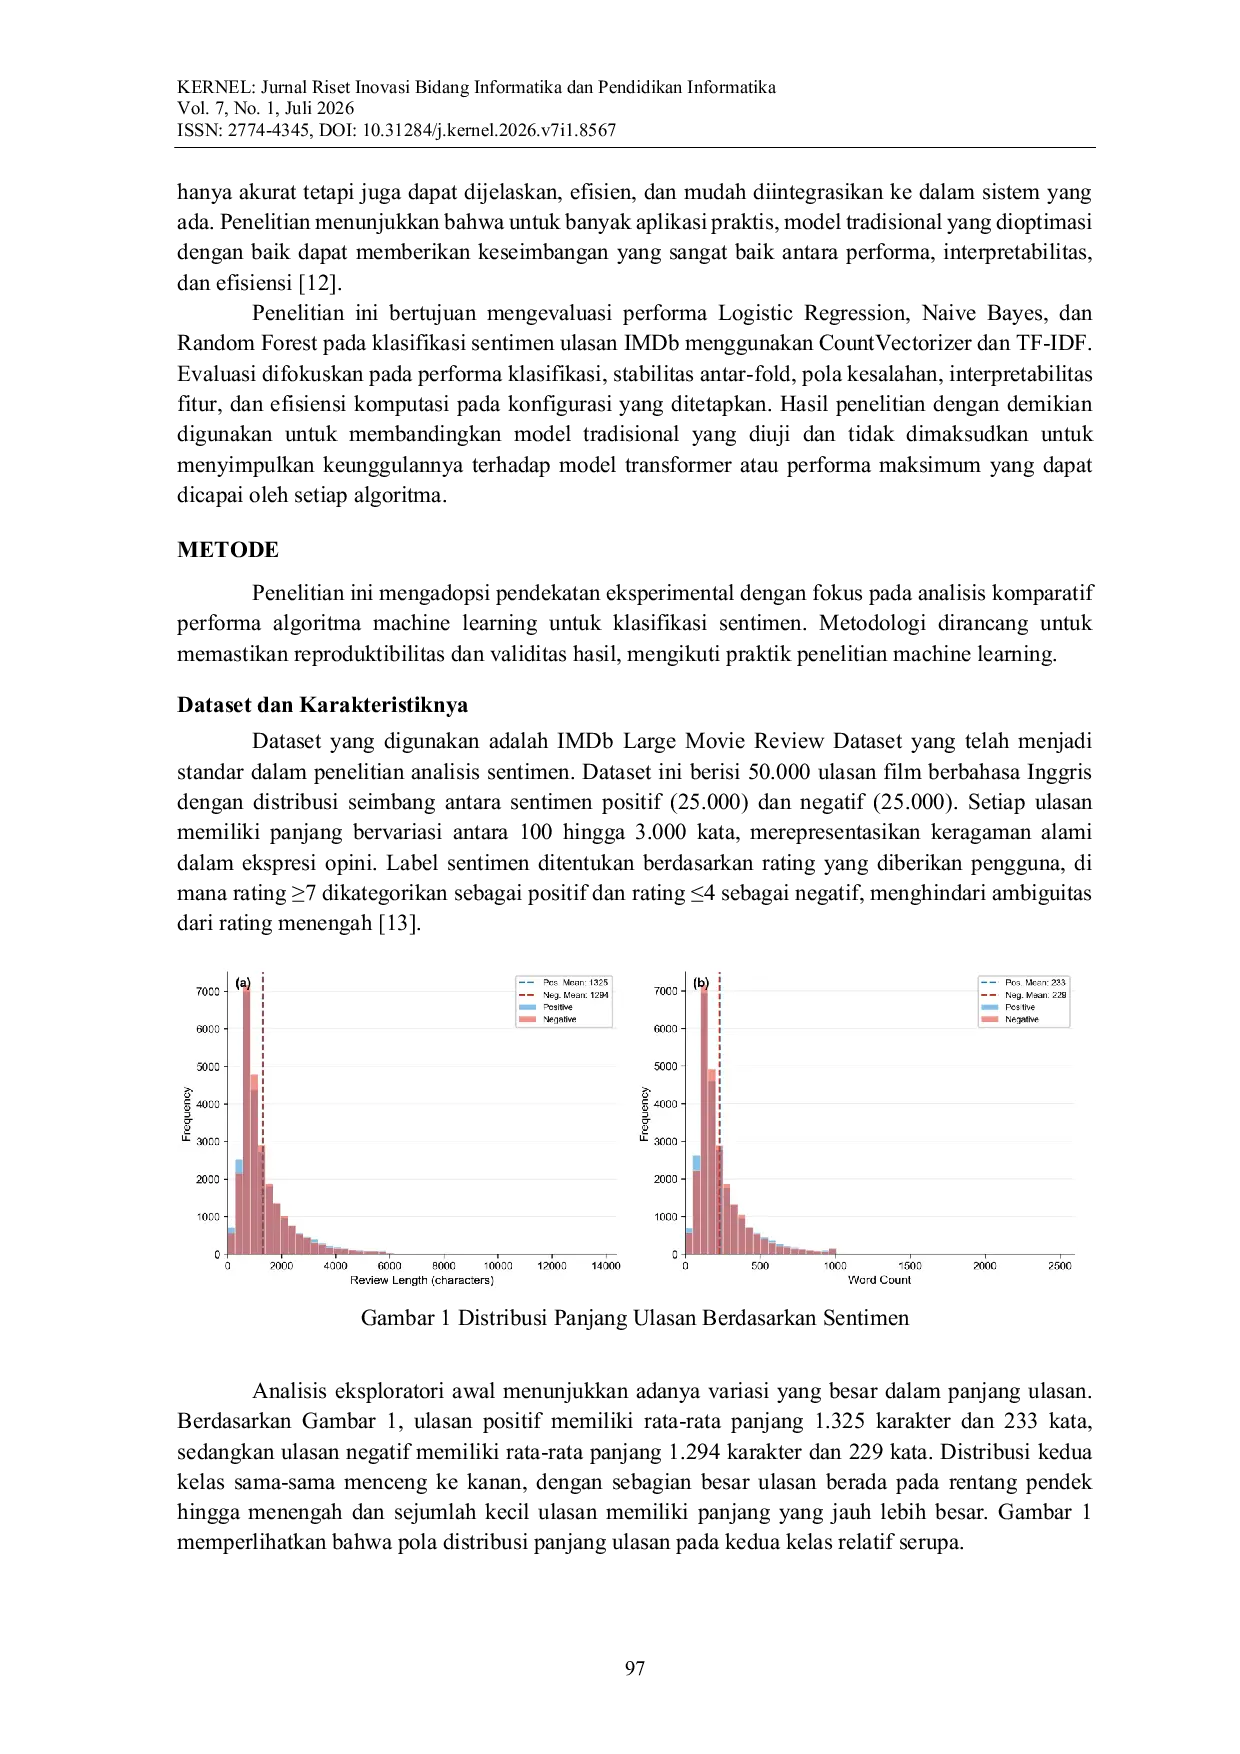
ITATSITATS Logistic Regression dengan TF-IDF mencapai performa terbaik dengan akurasi 87,29% dan F1-score 87,32%. Analisis feature importance mengungkap pola linguistikLogistic Regression dengan TF-IDF mencapai performa terbaik dengan akurasi 87,29% dan F1-score 87,32%. Analisis feature importance mengungkap pola linguistik
UBUB Penelitian lanjutan sebaiknya memperluas dataset ke mahasiswa dari fakultas lain, memperluas cakupan prediksi ke skala depresi dan kecemasan, serta mengintegrasikanPenelitian lanjutan sebaiknya memperluas dataset ke mahasiswa dari fakultas lain, memperluas cakupan prediksi ke skala depresi dan kecemasan, serta mengintegrasikan
UBUB Observasi perilaku dan log interaksi chatbot menunjukkan keterlibatan konsisten dalam proses penalaran reflektif, didukung oleh peningkatan 35,03 poinObservasi perilaku dan log interaksi chatbot menunjukkan keterlibatan konsisten dalam proses penalaran reflektif, didukung oleh peningkatan 35,03 poin
UBUB Studi perbandingan dilakukan pada dataset ESC-50, membandingkan model berbasis visual (EfficientNet-B0, ResNet-50) dengan model audio khusus (Pre-trainedStudi perbandingan dilakukan pada dataset ESC-50, membandingkan model berbasis visual (EfficientNet-B0, ResNet-50) dengan model audio khusus (Pre-trained

UMIUMI Penelitian ini menghasilkan model prediksi risiko stunting yang diimplementasikan dalam website sederhana, mendukung intervensi dini dan pengambilan keputusanPenelitian ini menghasilkan model prediksi risiko stunting yang diimplementasikan dalam website sederhana, mendukung intervensi dini dan pengambilan keputusan
UNUPASURUANUNUPASURUAN Metode penelitian yang digunakan sebagai pedoman yaitu kuantitatif dengan desain penelitian quase experimente. Teknik pengumpulan data yang dilaksanakanMetode penelitian yang digunakan sebagai pedoman yaitu kuantitatif dengan desain penelitian quase experimente. Teknik pengumpulan data yang dilaksanakan
UNRIYOUNRIYO Hasil akurasi klasifikasi mencapai 82,03%, dengan nilai AUC sebesar 0,935. Berdasarkan hasil eksperimen, algoritma KNN dapat diterapkan untuk mengklasifikasikanHasil akurasi klasifikasi mencapai 82,03%, dengan nilai AUC sebesar 0,935. Berdasarkan hasil eksperimen, algoritma KNN dapat diterapkan untuk mengklasifikasikan
Useful /
RCIPUBLISHERRCIPUBLISHER Desain penelitian yang digunakan adalah deskriptif analitik dengan pendekatan cross sectional, populasi penelitian ini adalah seluruh siswa kelas VII danDesain penelitian yang digunakan adalah deskriptif analitik dengan pendekatan cross sectional, populasi penelitian ini adalah seluruh siswa kelas VII dan

UMIUMI Hasil penelitian menunjukkan bahwa skor cibil adalah faktor paling berpengaruh dalam keputusan pemberian pinjaman. Skor cibil yang tinggi (kategori besar)Hasil penelitian menunjukkan bahwa skor cibil adalah faktor paling berpengaruh dalam keputusan pemberian pinjaman. Skor cibil yang tinggi (kategori besar)

UMIUMI Sistem mampu mengklasifikasikan daging ayam ke dalam tiga kategori. segar, kurang segar, dan busuk, dengan akurasi total 90% dari 30 pengujian. PerformaSistem mampu mengklasifikasikan daging ayam ke dalam tiga kategori. segar, kurang segar, dan busuk, dengan akurasi total 90% dari 30 pengujian. Performa

UMIUMI Data yang digunakan berupa citra multi-spektral dari satelit Himawari-8 yang mencakup berbagai kondisi atmosfer. Metode yang digunakan melibatkan dua pendekatanData yang digunakan berupa citra multi-spektral dari satelit Himawari-8 yang mencakup berbagai kondisi atmosfer. Metode yang digunakan melibatkan dua pendekatan